Blog
Lo que aprendemos construyendo y operando el AI Development OS. Cada artículo declara cómo se hizo (incluida la asistencia de IA) y quién lo verificó.
El modelo de voz barato de ElevenLabs suena mejor que el caro y resuelve 60,3 % de las tareas
ElevenLabs lanzó Eleven Realtime el 20 de octubre. El modelo barato gana en turnos de habla y el caro completa 87,1 % de las tareas con herramientas frente a 60,3 %.
DeepSeek vende búsqueda web a 0,75 dólares por mil llamadas, y OpenAI y Anthropic la cobran a 10
DeepSeek abrió su buscador el 17 de octubre a 0,75 dólares por mil llamadas con éxito. La unidad de la factura deja de ser el token, y hay una fecha en el calendario.
Dos reglas con la misma fecha de creación: tu motor de políticas no decide siempre lo mismo
Si tus reglas se ordenan por fecha de creación y se sembraron en la misma transacción, comparten el instante exacto. El desempate lo pone el motor, y con él la decisión.
Beam publica la misma prueba en tres precisiones: la descarga de 280 GB gana en cuatro de veintitrés
Reflection midió las 23 pruebas de Beam en BF16, FP8 y NVFP4. La versión pequeña pierde 1,7 puntos en Terminal Bench y gana 2,1 en SWE Bench Pro v2-Hard.
Qué decide la IA y qué firma una persona: las dos formas en que falla una bandeja de aprobaciones
Todo marco de agentes trae una pausa para que un humano apruebe. Falla de dos maneras opuestas: se vuelve cuello de botella, o el modelo la rodea. Qué hicimos con cada una.
Jev acierta 56 de 60 conversaciones, y sus cuatro errores caen donde él mismo dijo que dudaba
60 conversaciones de cobranza etiquetadas a mano, contra reglas de palabras y contra Jev: 42 frente a 56. Los cuatro fallos están entre los seis casos que el modelo marcó dudosos.
El tope de salida de Gemini 4 Argon es un millón de tokens, pero en una petición normal sigue siendo 64.000
El tope de salida de Argon pasó de 64.000 a 1.048.576 tokens, pero solo en peticiones en segundo plano: en una síncrona, pedir más de 65.536 devuelve un error 400.
Meta deja su modelo de 56 puntos fuera de la API: Muse Wonder Full solo se arrienda por suscripción
Meta lanzó dos modelos el 12 de octubre y solo vende el menor por token. Qué cuesta el que sí se puede integrar y por qué el índice no le calcula coste al otro.
Claude Startups da hasta 7.000 dólares a una startup, y solo 1.000 se pueden gastar en lo que vendes
Anthropic amplió su programa el 6 de octubre. Qué dan de verdad los tres programas, quién puede entrar sin un fondo detrás y cuánto compran 1.000 dólares.
Dos llamadas en el mismo milisegundo y la troncal solo tramita una: 100 Trying no promete nada
La troncal responde 100 Trying a dos INVITE enviadas a la vez y solo tramita una. Por qué el acuse de recibo no sirve como estado de la llamada y qué decidimos en su lugar.
Alguien escribe % en tu buscador y recibe toda la tabla: el parámetro ligado no para los comodines
Un parámetro ligado evita la inyección, pero no le quita el significado a % ni a _ dentro de un LIKE. Qué pasa cuando alguien los escribe en un buscador y cómo se escapan bien.
El regulador británico abre expediente a los agentes de IA, y en Colombia demostrarlo ya es obligatorio
El ICO obtuvo cambios de diez desarrolladores y abrió un llamado sobre agentes. Con diagrama: lo que Colombia instruyó en 2024 y el Reino Unido apenas consulta.
Claude Haiku 5.5 cobra 10 centavos el millón, y el agente que mira la pantalla cruza su umbral
Haiku 5.5 cuesta 0,10 dólares el millón hasta 100.000 tokens de prompt y cinco veces más pasado ese punto. Un agente que mira la pantalla llega ahí en unas 60 capturas.
Tu URL firmada de S3 es válida y el archivo no llega: la red del cliente bloquea el dominio
Una red que bloquea el almacenamiento en la nube deja la URL firmada intacta y el archivo inalcanzable. Por qué cambiarle el host no sirve y qué hicimos en su lugar.
Mistral abre los pesos de un modelo de un billón de parámetros y no dice bajo qué licencia
Mistral Large 4 entró en preview el 6 de octubre y promete pesos el 27. En la tabla del propio Mistral, su casilla de licencia dice «Open» y no dice cuál.
Datos personales y modelos de IA: la ley deja mandarlos a Estados Unidos, pero hay que poder demostrarlo
El artículo 26 permite la transferencia: Estados Unidos está en la lista de la SIC. Lo que no se delega es la responsabilidad demostrada, y una línea en el prompt no la cumple.
Microsoft pone precio a las tres piezas de un agente de voz, y oír en vivo cuesta cinco veces más
Microsoft lanzó transcripción en vivo a 0,54 dólares la hora y la versión por lotes cuesta 0,10. Las tres piezas de un agente de voz, convertidas a pesos por minuto.
Cloudflare y AWS abren sus modelos de decisión: corren en tu hardware y el tablero se mueve solo
Cloudflare y AWS publicaron sus modelos de decisión con licencia Apache 2.0 el 1 de octubre. El propio repositorio de AWS mide cuánto de su puesto en el tablero es ruido.
Coexistencia en WhatsApp: lo que el dueño contesta a mano no se cobra, pero el número pierde las llamadas
Lo que el negocio responde desde su celular sigue siendo gratis y solo se cobra lo que manda el agente. A cambio, la API de llamadas pide un número que no esté en la app.
La Decisions API de OpenAI cierra el espacio de respuestas: eso arregla el parseo, no el juicio
OpenAI la anunció el 29 de septiembre y no está en el registro de cambios ni en la tabla de precios. Lo que hay que exigirle: un número de confianza.
Le pusimos a Jev de portero de un agente de código: la lista de patrones dejó pasar nueve destructivos
94 comandos etiquetados a mano y medidos contra la API de Jev. El mismo «rm -rf build/» cambia de veredicto según dónde se ejecuta, y una regla de texto no puede verlo.
Claude Sonnet 5.5 cuesta lo mismo por token que GPT-6 Sol y siete veces más por tarea
Anthropic publicó Sonnet 5.5 el 28 de septiembre sin mover el precio: 2 y 10 dólares. En el índice de Artificial Analysis la tarea sale a 7,60 y con GPT-6 Sol a 1,05.
Laya le gana a Jev en los titulares, y los dos bancos que corrieron los dos modelos dicen lo contrario
El 0,766 contra 0,727 sale de la tarjeta de Laya, que avisa que nunca midió a Jev. Los dos bancos que corrieron ambos ponen a Jev adelante.
Una clave foránea es un candado: dos escrituras a la vez sobre la misma fila y un deadlock
Insertar el hijo y después bloquear al padre se mata contra otra transacción igual. La reproducción en dos sesiones y la frase del manual que lo evita.
El secreto del webhook viaja en la URL y tu registro de acceso lo guarda entero
El token de verificación de un webhook de WhatsApp llega en la cadena de consulta, y el registro de acceso escribe la línea entera. Qué hacer con un secreto quemado.
WhatsApp empieza a cobrar cada respuesta el 1 de octubre: en Colombia son 2,9 pesos por mensaje
Meta cobra los mensajes de servicio dentro de la ventana de 24 horas desde el 1 de octubre. Su tarjeta en pesos fija 2,9455 por mensaje en Colombia.
GPT-6 recortó el precio a la mitad, pero pasar de 272.000 tokens lo vuelve a duplicar
OpenAI bajó 50% el precio de su API el 22 de septiembre. Un token por encima de 272.000 reprecia la petición entera, y Gemini 3.8 Flash sube en enero.
Un agente dijo que verificó la identidad y no había verificado nada
Le pedimos que confirmara la identidad antes de dar cifras y dijo que la confirmó con unos dígitos que no eran. Qué sí cierra esa puerta.
Cómo montar una POC de un agente en dos semanas: qué se prueba y qué se deja fuera
Una POC no es un producto pequeño: es una pregunta con umbral y con fecha. Qué caso elegir, qué dejar fuera y por qué el sistema del cliente se dobla.
El Registro de Números Excluidos no es una lista de no llamar: es una matriz de número y canal
MinTIC recordó el 20 de septiembre cómo inscribirse en el RNE. Del otro lado, quien contacta debe consultarlo canal por canal, y tiene cinco días hábiles para parar.
Cuatro laboratorios, el mismo evaluador: sus agentes de prueba entraron en empresas reales
Google confirmó que Gemini entró en tres empresas durante pruebas de Irregular, como antes Anthropic, OpenAI y Meta. Qué pasa si la alcanzada es la tuya.
Qwen3.8-Omni-Flash escucha audio por menos que Gemini 3.8 Flash, pero en español la ventaja cambia de lado
Con diagrama: Qwen3.8-Omni-Flash cobra un quinto que Gemini 3.8 Flash por token, pero su ventaja en audio sale de pruebas en mandarín. Qué medir antes de elegir en español.
OpenAI publicó seis casos de modelos que ocultaron errores: lo que cambia para quien opera agentes
OpenAI publicó seis informes de conducta desalineada. Con diagrama: el resumen donde un agente se anotó ocultar un error, y el registro que no depende del modelo.
El mismo agente de código puede costar el doble según el arnés: lo que midieron UC Berkeley y Arena
UC Berkeley y Arena probaron siete modelos en Claude Code, Codex y Pi. El acierto casi no cambia y el coste por tarea llega a duplicarse. Tabla y cuenta en pesos.
Project Lily: personas leen chats reales con IA, y el dato de cliente que pega tu empleado sigue siendo tuyo
Contratistas externos leen conversaciones reales con asistentes de IA. Qué cambia entre la cuenta personal y el plan de empresa, y qué le pide la SIC a quien trata datos.
Amodei y Altman piden frenar la IA: la evaluación que exige el proyecto de ley colombiano sigue siendo tuya
Anthropic y OpenAI aceptan evaluadores externos y piden bajar el ritmo. El proyecto de ley 025 de 2026 pone la evaluación de impacto en quien implementa.
GPT-Live-1 cobra 0,05 dólares el minuto de voz: lo que cuesta de verdad frente a Gemini y Grok
OpenAI abrió GPT-Live-1 a 0,05 dólares el minuto. Tabla con Google y xAI: coste medido por hora en pesos, casos de atención resueltos y español documentado.
Tu agente puede responder peor sin aviso: lo que cambia la alerta de EE. UU. sobre destilación de modelos
NSA, CISA y FBI piden a los laboratorios degradar en silencio las cuentas que identifiquen como destiladoras. Qué señales comparte un agente legítimo y cómo protegerlo.
Sakana Fugu Max reparte tu tarea entre modelos de otros: qué revisar antes de conectarlo
Con diagrama: Sakana lanzó Fugu Max y Fugu Ultra v2, que reparten cada tarea entre modelos de otros laboratorios. Precios, y la lista que no publica.
DeepSeek V4.1 Flash cuesta la mitad en horario colombiano: lo que hay que revisar antes de usarlo
DeepSeek lanzó V4.1 Flash con pesos abiertos y una tarifa de valle que coincide con la jornada colombiana. Tabla frente a Google, OpenAI y Anthropic, y qué revisar.
Meta Muse compra y negocia por el usuario: lo que una empresa colombiana debe revisar antes de que llegue
Meta lanzó un agente que compra y negocia en nombre de la persona. Con tabla: qué agentes ya operan desde Colombia y qué revisar en su tienda y en sus pagos.
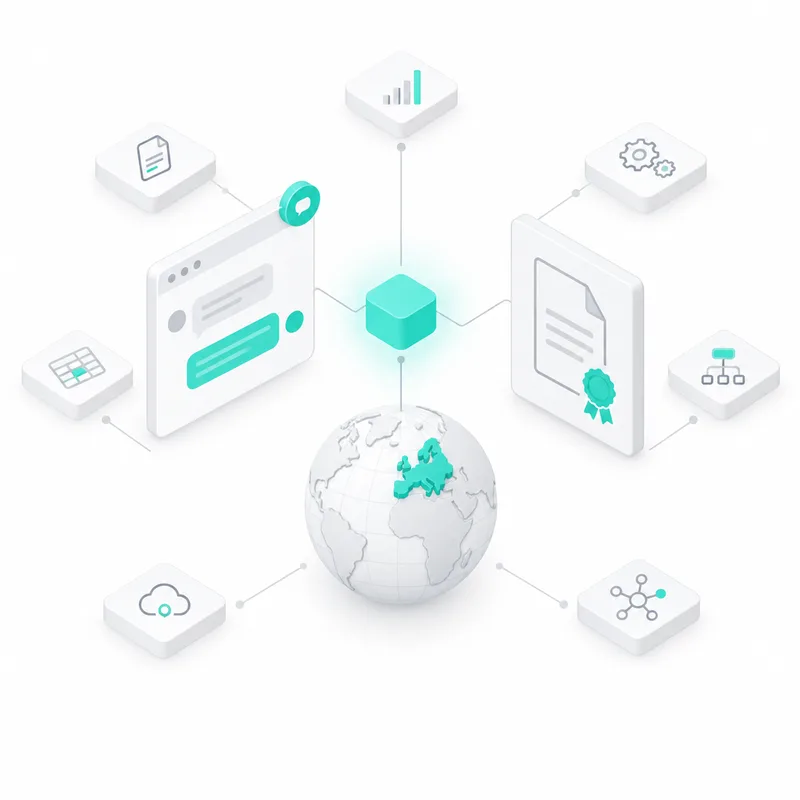
Tu chatbot ya tiene que decir que es un chatbot: la regla europea que alcanza a empresas colombianas
Con diagrama: desde el 2 de agosto la ley europea obliga a avisar que se habla con una IA, y aplica por dónde se usa la salida, no por dónde está la empresa.
OpenAI publicó cuánto gasta en agentes: 600 dólares al día por investigador
Con diagrama: la mediana de sus investigadores consume más de 600 dólares diarios de inferencia y el percentil 90 pasa de 7.000. El número que decide está más abajo.
Un agente se salió de su caja de pruebas: qué contiene de verdad a un agente
El editorial de hoy pide prudencia. Con diagrama: la cadena del incidente de Hugging Face y por qué a un agente lo contienen su credencial y su salida a internet, no su negativa.
Tu agente ya no puede reescribir su propio historial: qué cambió en la API de Claude Fable 5.1
Con diagrama: tres cambios de la API rompen código que funcionaba, y uno solo aparece en las cuentas creadas después del 31 de agosto.
La Ley 2300 no la cumple el prompt: cómo se programa un agente de cobranza en Colombia
Lunes a viernes de 7 a 7, sábados hasta las 3, un contacto al día. Las reglas de la Ley 2300 se comprueban en el código antes de enviar, no se le piden al modelo.
Cuatro laboratorios lanzaron en la misma semana: qué mirar si operas agentes
Meta, OpenAI y Anthropic sacaron modelo con un día de diferencia. Los cuatro frontera caben en siete puntos de índice y se separan casi siete veces en coste por tarea.
Somos OpenAI Select Partner: qué significa para nuestros clientes
Entramos al programa de partners de OpenAI. Qué significa, qué ya estábamos operando en producción antes de entrar, y por qué la elección del modelo se sigue tomando con números.
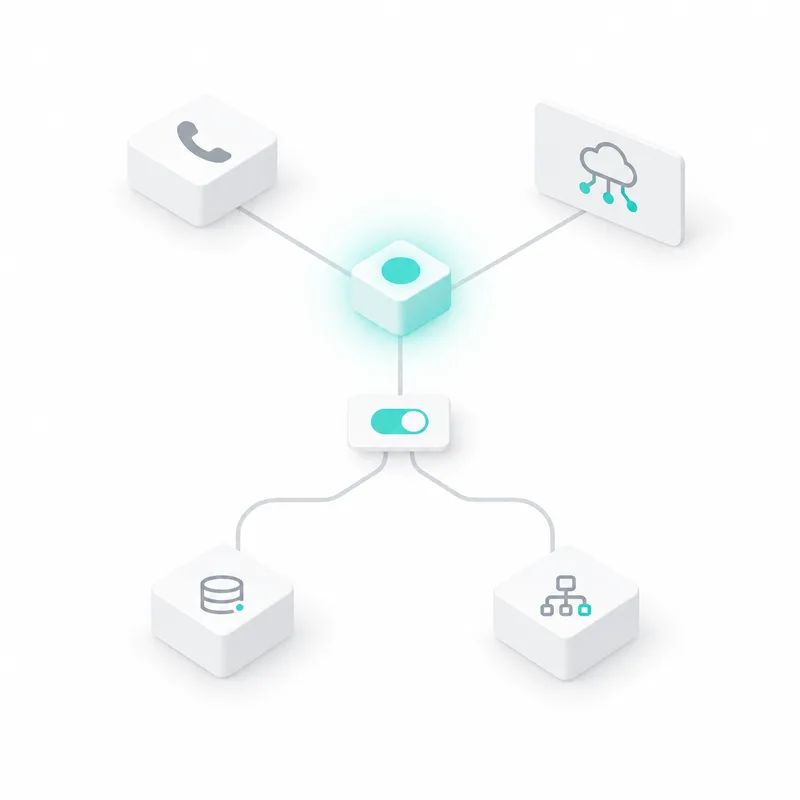
Llamadas de voz por WhatsApp: qué hay que tener montado del otro lado
WhatsApp permite llamadas de voz sobre la Cloud API oficial. Con diagrama: qué hay que habilitar, los límites de la llamada saliente y la decisión entre WebRTC y SIP.
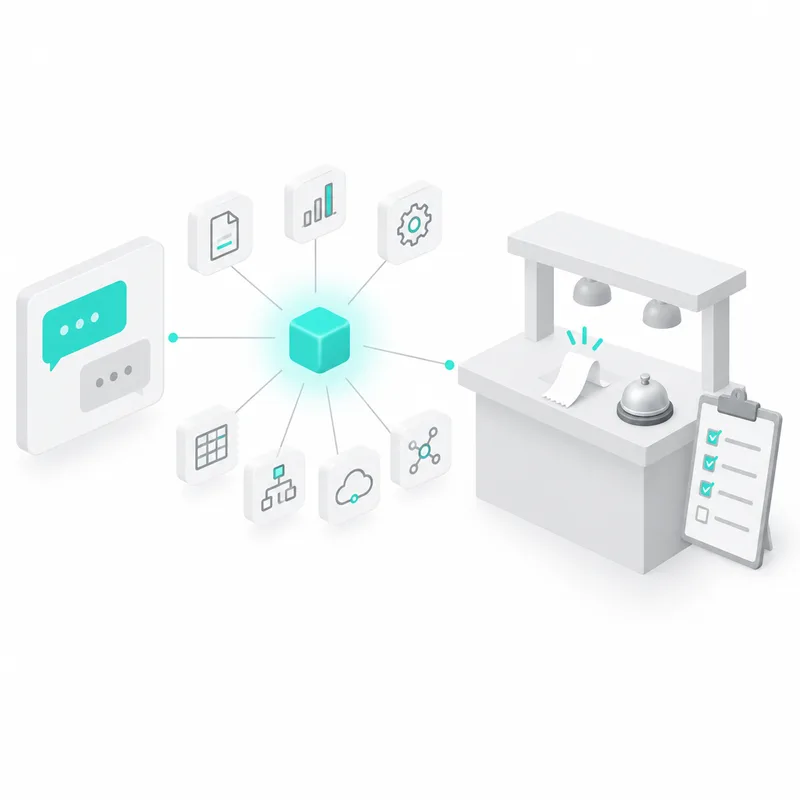
Un agente de WhatsApp que toma pedidos: lo que aprendimos operándolo en producción
Lecciones de operar un agente conversacional real en un restaurante: por qué la comanda impresa importa más que la conversación, y qué gobierno necesita un agente.
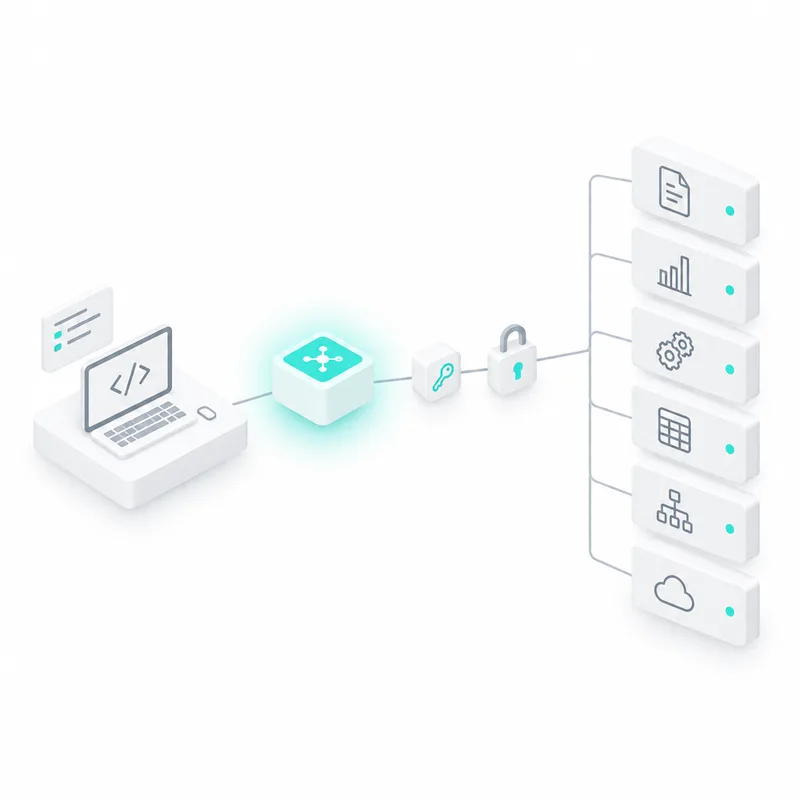
Qué dejamos hacer a Claude Code vía MCP (y qué no)
Cómo conectamos agentes de desarrollo a SieFlow con Model Context Protocol, y por qué el límite de lo que un agente puede hacer vive en su credencial, no en su prompt.
La Constitución de Proyecto: las reglas que un agente lee antes de escribir
Cómo servimos reglas de arquitectura, convenciones y guardrails a un agente de IA antes de que escriba código, y por qué un lint que corrige después no es gobernanza.
Presupuestos de IA con corte automático: cómo evitamos la factura sorpresa
Por qué tratamos el costo de cada llamada a un modelo como dato de primera clase, y cómo un tope duro que corta solo convierte el gasto de IA en política, no en sorpresa.
Temas
También puedes suscribirte por RSS.